


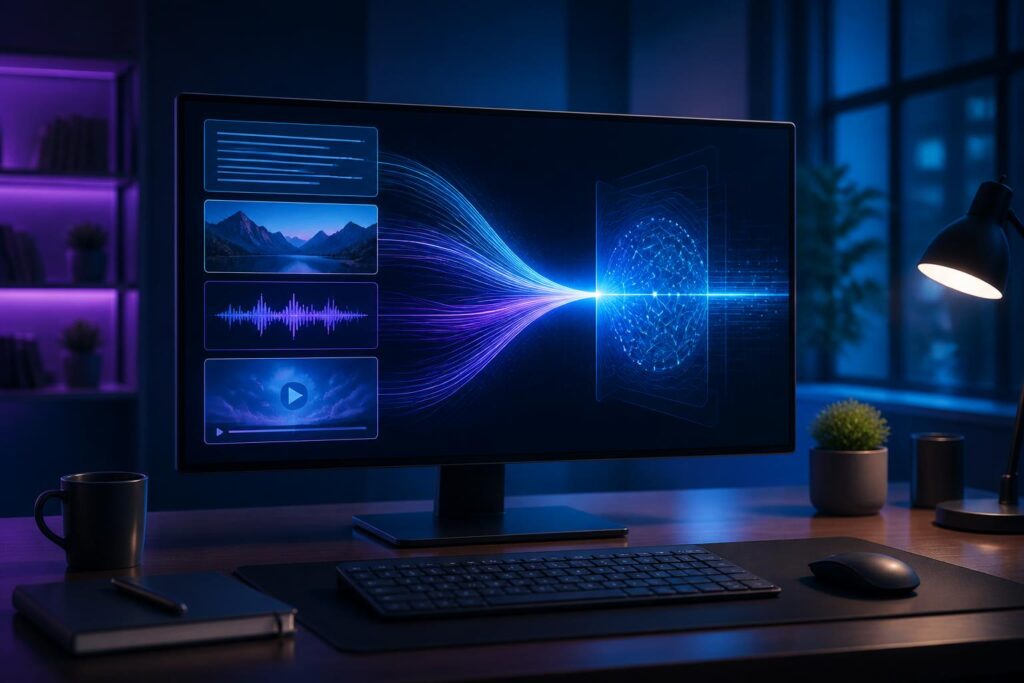
Trong một thời gian dài, phần lớn ứng dụng trí tuệ nhân tạo được xây dựng quanh một kênh giao tiếp chính: người dùng nhập văn bản và hệ thống trả lời bằng văn bản. Cách tương tác đó đã trở nên quen thuộc, nhưng không phản ánh đầy đủ cách con người tiếp nhận thông tin. Chúng ta thường đọc một tài liệu trong khi quan sát biểu đồ, nghe một cuộc họp cùng lúc xem màn hình trình chiếu, hoặc dùng hình ảnh để mô tả một vấn đề mà lời nói khó diễn đạt chính xác.
AI đa phương thức xuất hiện để xử lý sự đa dạng này. Thay vì chỉ làm việc với một loại dữ liệu, hệ thống có thể tiếp nhận và liên kết nhiều dạng đầu vào như chữ viết, hình ảnh, âm thanh và video. Mục tiêu không đơn giản là cho phép AI “nhìn” hay “nghe”, mà là giúp hệ thống hình thành một cách hiểu thống nhất hơn về nội dung được cung cấp. Người dùng có thể gửi ảnh kèm câu hỏi, đưa bản ghi âm vào để tóm tắt, hoặc yêu cầu phân tích mối liên hệ giữa một đoạn văn và một biểu đồ.
AI đa phương thức thực sự là gì?
Khái niệm đa phương thức chỉ khả năng xử lý nhiều loại tín hiệu hoặc định dạng dữ liệu trong cùng một quy trình. Một hệ thống có thể nhận diện vật thể trong ảnh, đọc phần chữ xuất hiện trên ảnh, đối chiếu với câu hỏi của người dùng rồi tạo ra câu trả lời bằng ngôn ngữ tự nhiên. Với âm thanh, hệ thống có thể chuyển lời nói thành văn bản, nhận biết các đoạn hội thoại và sử dụng nội dung đó cho một tác vụ tiếp theo. Với video, thách thức còn lớn hơn vì dữ liệu bao gồm cả hình ảnh thay đổi theo thời gian, âm thanh, lời thoại và đôi khi là chữ hiển thị trên khung hình.
Điểm quan trọng nằm ở khả năng kết nối các kênh thông tin, chứ không phải việc bổ sung thật nhiều chức năng riêng lẻ. Một công cụ đọc ảnh nhưng không hiểu câu hỏi đi kèm vẫn chỉ là phần mềm nhận dạng hình ảnh. Một hệ thống chuyển giọng nói thành văn bản nhưng không phân biệt được ai đang nói, câu nào là nội dung chính hay phần nào bị nhiễu cũng chưa mang lại nhiều giá trị cho công việc. AI đa phương thức hướng đến bước cao hơn: phân tích các tín hiệu trong quan hệ với nhau và tạo ra kết quả phù hợp với mục đích sử dụng.
Vì sao nhiều loại dữ liệu lại tạo ra khác biệt?
Văn bản có ưu điểm là rõ ràng, dễ tìm kiếm và dễ chỉnh sửa, nhưng không phải lúc nào cũng chứa đủ thông tin. Một bản mô tả bằng lời có thể không truyền tải được bố cục của một thiết kế, tình trạng của một thiết bị hoặc sự thay đổi trong một cảnh quay. Hình ảnh bổ sung thông tin về hình dạng, vị trí và tương quan không gian. Âm thanh lại cung cấp giọng nói, nhịp điệu, tiếng động và những dấu hiệu mà văn bản thuần túy có thể bỏ qua.
Khi những nguồn dữ liệu này được đặt trong cùng ngữ cảnh, người dùng có thể giao tiếp với AI theo cách gần với hoạt động tự nhiên hơn. Chẳng hạn, một nhân viên kỹ thuật có thể chụp ảnh bảng điều khiển, nêu hiện tượng bất thường bằng giọng nói và yêu cầu hệ thống chỉ ra những điểm cần kiểm tra trước. Một giáo viên có thể đưa vào bài giảng, hình minh họa và câu hỏi của học sinh để tạo ra tài liệu ôn tập phù hợp. Một nhóm truyền thông có thể dùng bản ghi âm cuộc phỏng vấn, hình ảnh sự kiện và bản nháp bài viết để rà soát sự nhất quán của nội dung.
Dù vậy, nhiều phương thức không đồng nghĩa với độ chính xác tự động cao hơn. Dữ liệu bổ sung có thể giúp hệ thống có thêm manh mối, nhưng cũng tạo ra nhiều cơ hội nhầm lẫn. Một hình ảnh thiếu sáng, một đoạn âm thanh lẫn tạp âm hoặc một video không có đủ ngữ cảnh đều có thể khiến mô hình suy diễn sai. Khi nhiều đầu vào mâu thuẫn nhau, hệ thống còn phải xác định nguồn nào đáng tin cậy hơn và mức độ chắc chắn của kết luận đến đâu.
Những ứng dụng gần với đời sống
Trong giáo dục, AI đa phương thức có thể hỗ trợ chuyển đổi tài liệu giữa các hình thức khác nhau. Nội dung từ một bài giảng có thể được tóm tắt thành văn bản, giải thích lại bằng ngôn ngữ đơn giản hơn hoặc chuyển thành câu hỏi ôn tập. Hình ảnh trong tài liệu cũng có thể được mô tả để hỗ trợ người học gặp khó khăn khi tiếp nhận thông tin trực quan. Tuy nhiên, giáo viên vẫn cần kiểm tra nội dung vì việc diễn giải sai một sơ đồ, công thức hoặc hình minh họa có thể dẫn đến hiểu nhầm kiến thức.
Trong chăm sóc khách hàng, người dùng không phải lúc nào cũng biết cách gọi tên một lỗi. Họ có thể gửi ảnh sản phẩm, đoạn video ngắn hoặc bản ghi âm mô tả sự cố. Hệ thống đa phương thức có thể giúp phân loại yêu cầu ban đầu, xác định thông tin còn thiếu và hướng dẫn các bước kiểm tra cơ bản. Giá trị lớn nhất trong trường hợp này không nhất thiết là thay thế hoàn toàn nhân viên, mà là rút ngắn thời gian từ lúc tiếp nhận đến khi vấn đề được chuyển cho đúng bộ phận.
Trong sản xuất và vận hành, hình ảnh từ thiết bị quan sát có thể được kết hợp với nhật ký bảo trì, hướng dẫn kỹ thuật và mô tả của người vận hành. Sự kết hợp ấy giúp quá trình tra cứu trở nên thuận tiện hơn, đặc biệt khi nhân viên cần tìm một đoạn hướng dẫn phù hợp với tình trạng thực tế. Nhưng mọi đề xuất liên quan đến an toàn, sửa chữa hoặc ngừng vận hành vẫn nên được xem là thông tin hỗ trợ, không phải quyết định cuối cùng nếu chưa có người có chuyên môn xác nhận.
Trong công việc văn phòng, ứng dụng phổ biến hơn có thể là xử lý cuộc họp. Hệ thống có thể nhận bản ghi âm, phân biệt các phần thảo luận, kết hợp với tài liệu được trình bày và tạo ra bản tóm tắt. Nếu được dùng đúng cách, công cụ này giúp người tham dự tập trung vào trao đổi thay vì ghi chép liên tục. Dẫu vậy, bản tóm tắt vẫn cần được đối chiếu với bản gốc, nhất là khi cuộc họp có nhiều ý kiến trái chiều, thuật ngữ chuyên ngành hoặc quyết định phụ thuộc vào một câu nói có điều kiện.
Thách thức về ngữ cảnh và quyền riêng tư
Khả năng xử lý hình ảnh, âm thanh và video làm cho AI đa phương thức hữu ích hơn, đồng thời khiến câu hỏi về dữ liệu trở nên nghiêm trọng hơn. Một bức ảnh có thể chứa khuôn mặt, giấy tờ, màn hình máy tính hoặc thông tin vị trí. Một bản ghi âm có thể tiết lộ danh tính, nội dung trao đổi riêng tư và những thông tin mà người nói không dự định chia sẻ với hệ thống. Video thường kết hợp tất cả các dạng dữ liệu đó trong một tệp duy nhất.
Vì vậy, tổ chức triển khai AI cần xác định rõ dữ liệu nào được phép đưa vào, dữ liệu nào phải che mờ hoặc loại bỏ, ai có quyền truy cập và thời gian lưu trữ là bao lâu. Việc xin phép người liên quan không nên được xem là một thủ tục hình thức. Người dùng cần biết dữ liệu của họ được dùng cho mục đích gì, kết quả do hệ thống tạo ra sẽ được ai xem và họ có lựa chọn nào nếu không muốn tiếp tục cung cấp dữ liệu.
Ngữ cảnh cũng là một giới hạn lớn. Một bức ảnh về thiết bị có thể cho thấy dấu hiệu bất thường, nhưng không cho biết lịch sử sử dụng, điều kiện môi trường hay những sửa chữa trước đó. Một đoạn hội thoại có thể được chép lại chính xác từng câu nhưng vẫn bị hiểu sai nếu thiếu giọng điệu, cử chỉ hoặc phần trao đổi diễn ra ngoài bản ghi. Bởi vậy, câu trả lời có vẻ mạch lạc chưa chắc đã phản ánh đầy đủ sự việc.
Thiết kế trải nghiệm thay vì chỉ thêm tính năng
Một sai lầm thường gặp khi triển khai AI đa phương thức là tập trung vào việc hệ thống nhận được bao nhiêu định dạng dữ liệu, thay vì người dùng cần giải quyết vấn đề nào. Không phải tác vụ nào cũng cần ảnh, âm thanh và video cùng lúc. Nếu quy trình chỉ cần một biểu mẫu rõ ràng, việc bổ sung quá nhiều kênh có thể làm tăng chi phí, gây khó kiểm soát và khiến người dùng bối rối.
Thiết kế tốt nên bắt đầu bằng câu hỏi về quyết định cần hỗ trợ. Đầu vào nào thực sự cần thiết? Dữ liệu nào có thể gây nhiễu? Khi hệ thống không chắc chắn, người dùng có được yêu cầu bổ sung thông tin hay chuyển sang nhân viên hay không? Kết quả nên hiển thị dưới dạng bản tóm tắt, danh sách điểm cần chú ý hay đề xuất hành động? Câu trả lời cho những câu hỏi này quan trọng không kém khả năng kỹ thuật của mô hình.
Giao diện cũng nên cho người dùng biết hệ thống đã sử dụng nguồn nào để tạo ra kết quả. Với một bản tóm tắt cuộc họp, chẳng hạn, việc liên kết từng kết luận với đoạn ghi âm hoặc phần tài liệu tương ứng sẽ giúp người dùng kiểm tra nhanh hơn. Với phân tích hình ảnh, hệ thống nên thể hiện những giới hạn phù hợp thay vì trình bày suy đoán như một nhận định chắc chắn. Cách diễn đạt về mức độ tin cậy cần rõ ràng, dễ hiểu và gắn với hành động tiếp theo.
Doanh nghiệp nên chuẩn bị gì?
Trước khi đưa AI đa phương thức vào quy trình, doanh nghiệp nên bắt đầu từ một trường hợp sử dụng hẹp, có tiêu chí thành công cụ thể và dữ liệu tương đối ổn định. Một thử nghiệm nhỏ giúp tổ chức phát hiện những vấn đề thường bị bỏ qua như chất lượng bản ghi, định dạng tệp, quyền truy cập, ngôn ngữ địa phương và thời gian con người phải kiểm tra lại kết quả.
Quy trình đánh giá cũng cần bao gồm các tình huống khó, không chỉ những mẫu dữ liệu đẹp. Hãy xem hệ thống phản ứng ra sao với hình ảnh bị che khuất, âm thanh nhiễu, câu hỏi mơ hồ, nhiều người nói cùng lúc hoặc thông tin mâu thuẫn. Cần ghi nhận cả lỗi bỏ sót và lỗi khẳng định sai, bởi hai loại lỗi này có thể tạo ra hậu quả khác nhau tùy lĩnh vực.
Quan trọng hơn, AI đa phương thức không nên được triển khai như một lớp công nghệ tách rời khỏi quy trình quản trị dữ liệu. Doanh nghiệp cần quy định trách nhiệm của người sử dụng, cách xử lý nội dung nhạy cảm, phương án khi hệ thống không hoạt động và cơ chế tiếp nhận phản hồi. Đào tạo người dùng cũng phải giải thích rằng AI có thể hỗ trợ quan sát, tra cứu và soạn thảo, nhưng không tự động biến thông tin chưa đầy đủ thành sự thật.
Triển vọng thực tế của AI đa phương thức
AI đa phương thức mở ra một cách tương tác tự nhiên hơn giữa con người và phần mềm. Người dùng không còn phải chuyển mọi trải nghiệm thành câu chữ trước khi yêu cầu trợ giúp. Hình ảnh, âm thanh và video có thể trở thành một phần của quy trình làm việc, từ giáo dục, dịch vụ khách hàng đến vận hành kỹ thuật.
Tuy nhiên, tương lai của công nghệ này sẽ không chỉ phụ thuộc vào việc mô hình có thể tiếp nhận bao nhiêu loại dữ liệu. Giá trị bền vững nằm ở khả năng hiểu đúng ngữ cảnh, bảo vệ dữ liệu, trình bày giới hạn và hỗ trợ con người kiểm tra kết quả. Một hệ thống tốt không phải là hệ thống luôn đưa ra câu trả lời ngay lập tức, mà là hệ thống biết khi nào cần thêm thông tin, khi nào nên nêu rõ sự không chắc chắn và khi nào phải chuyển quyền quyết định cho con người.
Với cách tiếp cận đó, AI đa phương thức có thể trở thành một lớp giao tiếp hữu ích giữa dữ liệu phong phú và công việc hằng ngày. Công nghệ sẽ phát huy hiệu quả nhất khi được thiết kế để bổ sung năng lực của con người, thay vì tạo ra ảo tưởng rằng mọi điều nhìn thấy, nghe được hoặc đọc được đều đã được hiểu chính xác.
